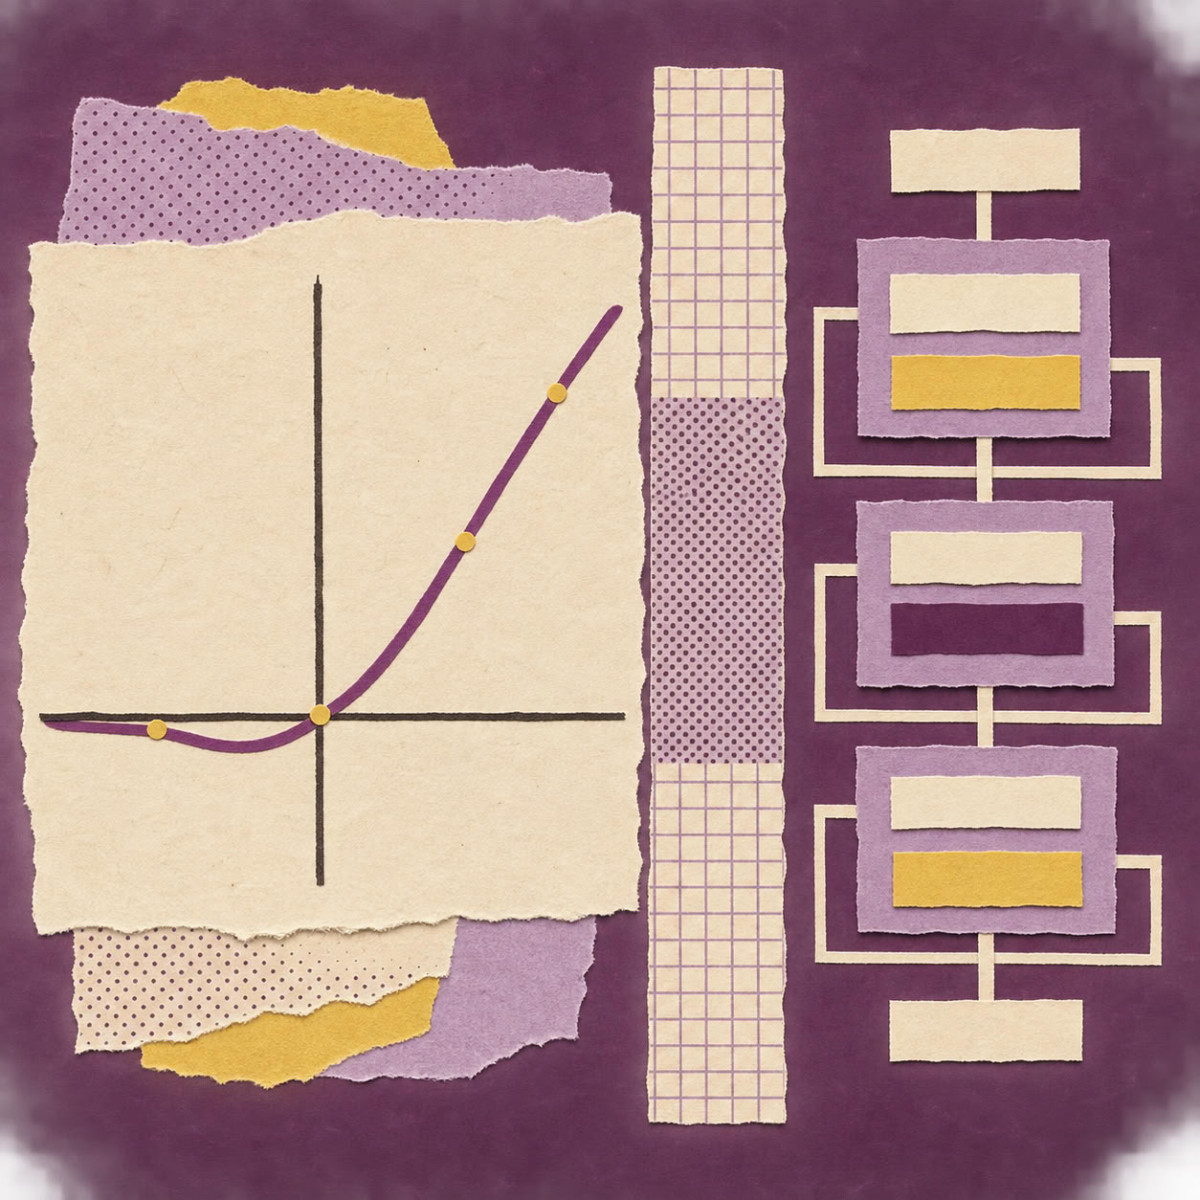

Pourquoi les modèles Transformer, comme BERT, utilisent-ils la fonction GELU plutôt que la fonction ReLU ? Selon un article publié par Analytics Vidhya, la réponse tient à la manière dont chacune traite l’information. Là où ReLU supprime entièrement les entrées négatives, GELU applique un mécanisme lisse, qui dépend de la valeur de chaque entrée, pour décider quelle part de l’information doit passer.
- GELU pondère chaque entrée selon sa valeur, sans seuil strict contrairement à ReLU.
- Elle est déterministe, mais son effet peut sembler probabiliste.
- Elle est plus coûteuse en calcul que ReLU, car sa formule fait appel à la loi normale.
- Elle est utilisée dans les réseaux à propagation avant des Transformers comme BERT, sans être automatiquement meilleure.
GELU, pour Gaussian Error Linear Unit, est une fonction d’activation non linéaire introduite en 2016 par Dan Hendrycks et Kevin Gimpel. Une fonction d’activation détermine la façon dont un neurone transforme son entrée avant de la transmettre à la couche suivante. Sans elle, l’empilement de couches linéaires ne produirait qu’une transformation globalement linéaire, ce qui limiterait ce que peut apprendre un réseau de neurones.
GELU ne applique pas de seuil strict. Elle met à l’échelle chaque entrée en fonction de sa valeur. Les fortes valeurs positives passent presque inchangées, les valeurs proches de zéro sont partiellement atténuées et les fortes valeurs négatives sont ramenées vers zéro. Les valeurs modérément négatives peuvent conserver une petite sortie négative. L’article note que l’article original de GELU a évalué la fonction en vision par ordinateur, en traitement du langage naturel et en reconnaissance vocale, et qu’il a fait état d’améliorations par rapport à plusieurs fonctions traditionnelles dans ses expériences.
GELU face à ReLU
ReLU, pour Rectified Linear Unit, renvoie 0 pour une entrée négative et la valeur elle-même pour une entrée positive. Ainsi, pour une entrée de -1, elle renvoie 0, et pour une entrée de 2, elle renvoie 2. GELU se comporte différemment : une entrée de -1 donne environ -0,159, et une entrée de 2 donne environ 1,954. La fonction n’est donc pas strictement croissante sur l’ensemble de son domaine, sa zone négative présentant un léger creux avant de se rapprocher de zéro pour les valeurs très négatives.
GELU s’écrit x × Φ(x), où Φ(x) est la fonction de répartition de la loi normale centrée réduite, c’est-à-dire une loi de moyenne zéro et d’écart type un. Cette fonction s’exprime à l’aide de la fonction d’erreur erf. Pour une entrée de 1, la valeur de Φ est environ 0,8413 : le signal positif est donc largement conservé, tandis que le signal négatif de -1 est fortement réduit. Le texte précise que GELU est déterministe. Elle ne supprime pas aléatoirement des sorties de neurones pendant l’exécution, même si son fonctionnement est parfois décrit comme un mécanisme de filtrage probabiliste.
ReLU reste populaire parce qu’elle est simple et peu coûteuse en calcul. GELU offre une transformation plus lisse, mais sa forme mathématique demande davantage de calculs. L’article souligne en outre qu’aucune des deux n’est automatiquement meilleure : l’architecture du modèle, le jeu de données, le matériel et l’implémentation influencent tous le résultat final.
Pourquoi GELU est-elle présente dans les Transformers
Un Transformer, l’architecture sur laquelle reposent BERT et de nombreux grands modèles de langage, combine des mécanismes d’attention, des couches de normalisation et des réseaux de neurones dits à propagation avant, ou FFN. GELU est couramment utilisée dans le FFN, et non dans le calcul des probabilités d’attention. Dans l’architecture BERT, elle est la fonction d’activation par défaut des couches cachées, comme l’indique la configuration BERT de Hugging Face. Elle apparaît aussi dans les Transformers de vision, mais certains modèles récents utilisent des variantes à porte fondées sur SiLU, comme SwiGLU.
La formule exacte de GELU fait appel à la fonction de répartition gaussienne, plus coûteuse à calculer que des fonctions plus simples. L’article présente une approximation courante reposant sur la fonction tangente hyperbolique, qui produit des valeurs proches de GELU exacte. PyTorch permet d’utiliser les deux formulations grâce à son paramètre approximate.
Une expérience en Python
L’auteur compare deux réseaux identiques, l’un avec ReLU et l’autre avec GELU, sur le jeu de données make_moons de scikit-learn, composé de 2 000 échantillons. Les deux modèles partagent la même architecture, le même optimiseur Adam, le même taux d’apprentissage de 0,001 et la même graine aléatoire, sur 100 époques. L’article prévient qu’une seule exécution ne suffit pas à établir la meilleure fonction : il recommande de répéter l’expérience avec plusieurs graines aléatoires et de réserver l’ensemble de test à l’évaluation finale. Son objectif n’est pas de démontrer que GELU est universellement supérieure.
Pour un modèle pré-entraîné, le texte recommande généralement de conserver la fonction d’activation d’origine. Remplacer GELU par ReLU dans un Transformer pré-entraîné modifie ses calculs et peut réduire ses performances, sauf si le modèle modifié est correctement réentraîné ou affiné.
