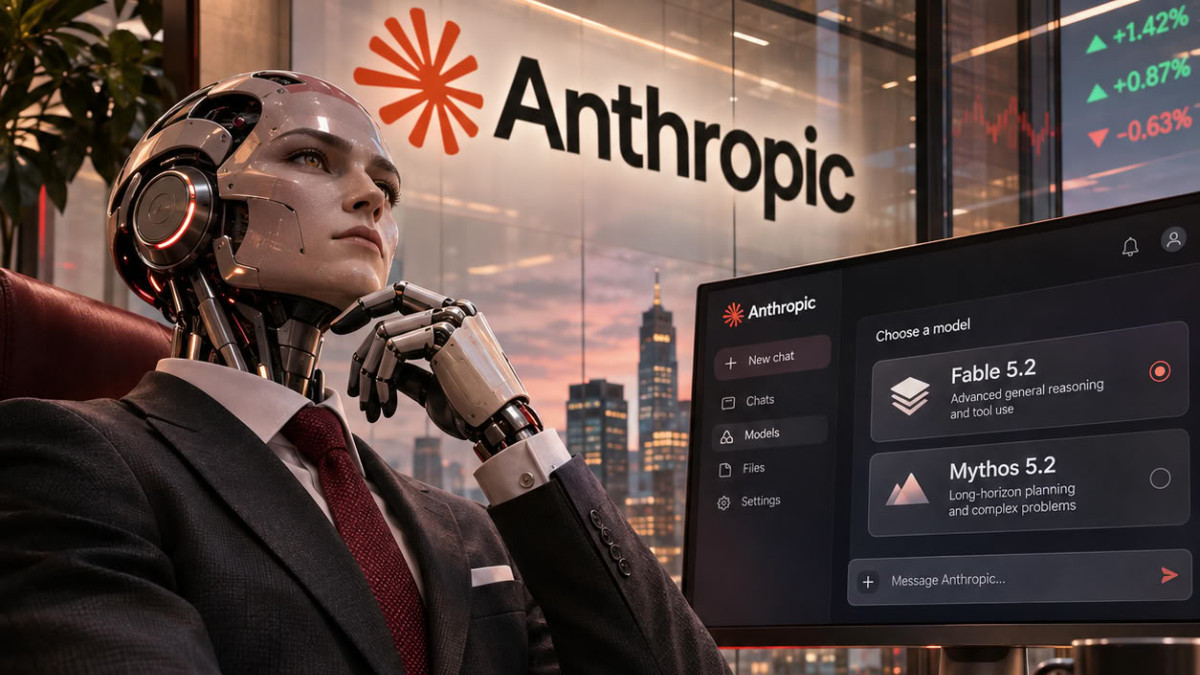

Enkele maanden voor zijn beursgang (IPO) heeft de uitgever van Claude op maandag 9 november de nieuwe versie van zijn krachtigste model onthuld. Het is beschikbaar in twee varianten, Claude Fable 5.2 en Claude Mythos 5.2, en laat vooruitgang zien in code, redeneren en visie, en richt zich op wetenschappelijk onderzoek en robotica. De prijs is verlaagd.
Claude Fable 5.2 is bedoeld voor het grote publiek, terwijl Claude Mythos 5.2 versterkte cybercapaciteiten biedt voor geselecteerde organisaties, binnen het kader van verificatieprogramma’s voor cybersecurity en levenswetenschappen. De twee varianten zijn in werkelijkheid gebaseerd op één en hetzelfde model. Het verschil zit vooral in de veiligheidsmaatregelen die op hun output worden toegepast: Mythos kan geavanceerde cybersecurity- en biologietaken uitvoeren, terwijl Fable 5.2 strikte veiligheidsmaatregelen toepast en vaak weigert te antwoorden.
Een model gepresenteerd als universeel
Anthropic positioneert Fable 5.2 als een model geschikt voor alle complexe taken, en niet alleen als een referentiemodel voor code. Op de benchmark FrontierCode 2.0 behaalt het 49,1% voor agentische code, tegenover 45,5% voor Claude Opus 5.5. Voor bugoplossing (FrontierSWE v2) bereikt het 69,9%, tegenover 62,3% voor Opus 5.5. Voor webonderzoek (WANDR, relaxed score) scoort het 82,1%, tegenover 72,3% voor Opus 5.5.
In de automatisering van bedrijfsworkflows blijft het echter achter bij Gemini 4 Carbon, met 51,4% tegenover 53,9% op AutomationBench. De gerapporteerde gegevens plaatsen het ook aan de top voor visie en computergebruik, met kleinere voorsprongen.
Robotica en wetenschappelijk onderzoek
De meest opvallende vooruitgang betreft robotica. Op RoboDojo Sim, een robotica-simulatietest, behaalt Fable 5.2 64,9%, tegenover 39,4% voor Opus 5.5 en 29,8% voor GPT-6 Astra. Voor autonoom wetenschappelijk onderzoek (Terminal-Bench-Science 0.1) bereikt het 74,6%, tegenover 68,1% voor GPT-6 Astra.
Volgens de gepubliceerde informatie heeft Fable 5.2 autonoom twee nog openstaande vragen uit de natuurkunde over zwarte gaten opgelost. Mythos 5.2 heeft op zijn beurt twee open-source modellen aangestuurd om de structuur van AAV-capsiden te voorspellen, de omhulsels van virussen gebruikt in gentherapie, met 28 successen op 34. Een team van 1000 Fable 5.2-agents heeft het bewijs van de stelling van Fermat in 30 uur geverifieerd via de computer, terwijl Opus 5.5 er slechts 26% van had afgerond in 18 uur. Anthropic beweert ook dat zijn model kan generaliseren naar bepaalde situaties die niet zijn geleerd tijdens de training, een vermogen dat sommige onderzoekers doet twijfelen aan de langetermijnrelevantie van world models, deze modellen die het functioneren van de wereld simuleren.
Een lagere prijs, een hogere kost per taak
Anthropic kondigt een prijsdaling aan van ongeveer 20% ten opzichte van Claude Fable 5.1, naar 8 dollar per miljoen tokens voor invoer en 40 dollar voor uitvoer, tegenover 10 en 50 dollar eerder. Een token is een teksteenheid die het model verwerkt. Volgens Artificial Analysis blijft het model echter duurder voor de geteste taken. Volgens de index van de organisatie kost een taak ongeveer 6 dollar met GPT-6 Astra, ongeveer tien dollar met Opus 5.5 en bijna 27 dollar met Fable 5.2.
Het model is bovendien tot 30% sneller dan Fable 5.1, met ongeveer 98 tokens per seconde bij maximale redeneercapaciteit volgens Artificial Analysis, tegenover 77 voor Gemini 4 Carbon. Het kan tot 50% van de wekelijkse gebruikslimieten verbruiken op de standaard Pro- en Team-abonnementen.
Deze positionering past in het perspectief van de IPO. Anthropic richt zich nu op nieuwe sectoren, zoals wetenschappelijk onderzoek, biologie en robotica, wat volgens de analyse waaruit deze informatie afkomstig is, zijn klantenbestand en zijn terugkerende inkomsten zou kunnen verbreden in de aanloop naar de beursgang.
